普通 Body 按 Content-Length 收齐,chunked Body 按块长度和终止块解码。两套边界不能混用,也不能依赖字符串结束符猜测。
适合谁收藏
- 正在实现 PLC 端 HTTP Server 的工程师。
- 正在排查监听、多连接、请求边界或响应发送问题的人。
- 需要建立 Server 真机验收清单的读者。
服务器篇,第 5/7 篇;主系列第 09/28 篇。
现场问题
当 Content-Length 比实际 Body 大,Server 会继续等;比实际 Body 小,后续字节可能污染下一次事务。chunked 更容易误判,因为长度不是写在 Header 里,而是分散在每个块前面。
PLC 侧没有无限缓冲区。边界判断除了符合协议,还必须在最大 Header、最大 Body 和最大消息容量内失败得足够明确。
先给结论
普通消息用声明长度收口,chunked 消息用十六进制块长度、CRLF 和 0 终止块收口。任何非法长度、缺失 CRLF、超限或 TE/CL 冲突都必须停止解析。
读图重点
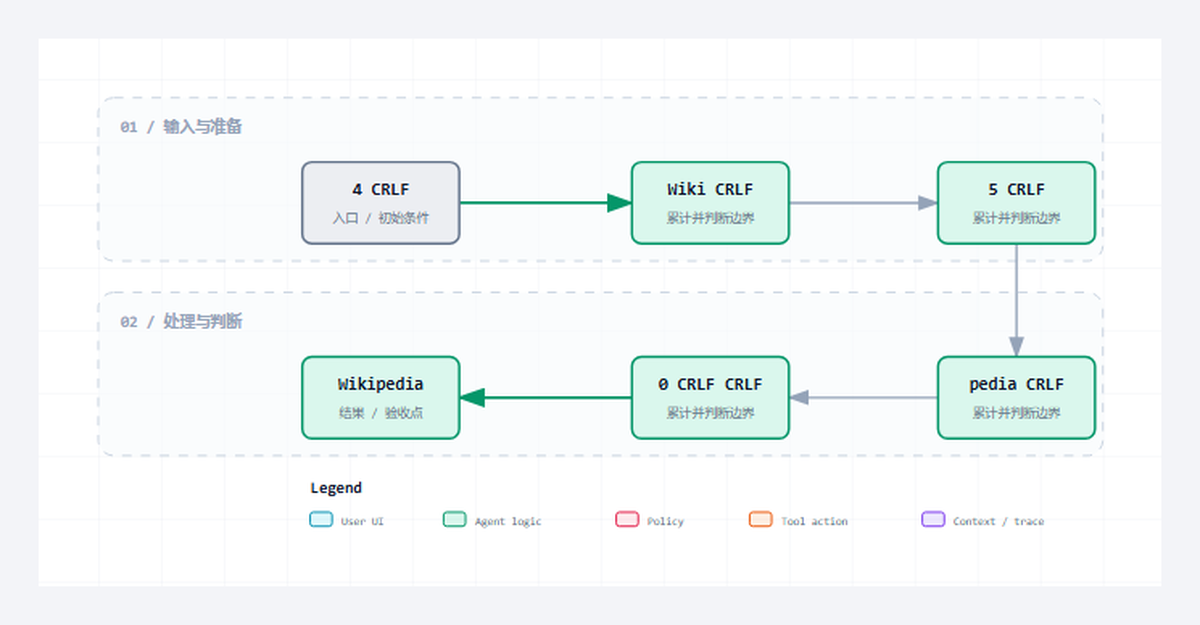
这张图只压缩本篇的判断路径。读图时先找“Content-Length”对应的输入边界,再沿着“解码后不超过 1023 字节”检查状态怎样推进,最后用“超限返回 BodyTooLarge”确认输出是否已经形成验收证据。
把对象和边界分开
| 对象或阶段 | 工程职责 | 现场观察点 |
|---|---|---|
| Content-Length | 十进制 Body 字节数 | 收齐前返回 NeedMoreData |
| chunk-size | 十六进制块长度 | 允许分号扩展但不解释语义 |
| 0 块 | chunked 正文结束 | 后续只验证 trailer 结束 |
| 容量 | 解码后不超过 1023 字节 | 超限返回 BodyTooLarge |
从协议约束到代码职责
协议约束
普通消息用声明长度收口,chunked 消息用十六进制块长度、CRLF 和 0 终止块收口。任何非法长度、缺失 CRLF、超限或 TE/CL 冲突都必须停止解析。 这条结论先限定消息什么时候成立,再限定哪个角色可以消费结果。若绕过协议边界直接驱动业务,半包、超时、重复执行和连接残留就会进入应用层。
工程抽象
当前解码器先扫描 chunk-size 行,再调用 F_HttpParseHexSize。只有长度、数据和尾部 CRLF 都验证通过后才复制 Body,避免输出保留半截非法数据。
首版不生成 chunked 出站报文,统一用 Content-Length 构造请求和响应。这是工程取舍:接收端必须兼容真实 HTTP 对端,发送端则选择更容易诊断的确定长度。
- Content-Length:工程职责是“十进制 Body 字节数”。它不能只停留在命名层面,运行时必须能通过“收齐前返回 NeedMoreData”观察到输入、状态或结果;否则这一层即使有代码,也没有形成可验证边界。
- chunk-size:工程职责是“十六进制块长度”。它不能只停留在命名层面,运行时必须能通过“允许分号扩展但不解释语义”观察到输入、状态或结果;否则这一层即使有代码,也没有形成可验证边界。
- 0 块:工程职责是“chunked 正文结束”。它不能只停留在命名层面,运行时必须能通过“后续只验证 trailer 结束”观察到输入、状态或结果;否则这一层即使有代码,也没有形成可验证边界。
- 容量:工程职责是“解码后不超过 1023 字节”。它不能只停留在命名层面,运行时必须能通过“超限返回 BodyTooLarge”观察到输入、状态或结果;否则这一层即使有代码,也没有形成可验证边界。
程序单元
本篇主证据来自 FB_HttpChunkedDecoder.st 中以 IF udiChunkSize = 0 THEN 为定位点的连续源码。这里不是为了展示语法,而是把协议约束落到确定程序单元:输入先进入结构体或缓冲区,状态机只在本周期处理可确认的部分,长度和结束条件决定能否前进,错误码与指标负责把失败原因带出对象边界。这样一来,“消息边界必须由协议字段决定。”可以在代码、在线变量和外部报文之间逐项对照,而不是依赖经验猜测。
本篇核心源码片段
下面两段代码来自同一个真实文件 FB_HttpChunkedDecoder.st,以 IF udiChunkSize = 0 THEN 为中心连续截取,没有改写变量、删除分支或用伪代码替代。第一段用于确认入口与前置条件,第二段用于确认状态、边界和输出。核对时重点看“十进制 Body 字节数”怎样进入对象,以及“超限返回 BodyTooLarge”怎样证明本次处理已经结束。若两段之间的连续关系无法解释“校验通过之前不要修改最终 Body。”,就不能把局部代码截图当成实现证据。
片段一:入口、声明与前置条件
        FOR uiLineIndex := 0 TO uiLineLen - 1 DO
            pLine^ := pInput[uiIndex + uiLineIndex];
            pLine := pLine + 1;
        END_FOR
    END_IF
    pLine^ := 0;

    IF NOT F_HttpParseHexSize(
        sValue   := sLine,
        udiValue => udiChunkSize
        ) THEN
        bError := TRUE;
        eError := E_HttpError.iChunkedDecodeFailed;
        sDiagMsg := 'chunk size parse failed';
        RETURN;
    END_IF

    uiIndex := uiScan + 2;
    IF udiChunkSize = 0 THEN
        // 零长度块后若直接出现 CRLF,则判定为空 trailer 并立即完成。
        IF ((uiIndex + 1) < uiInputLen)
            AND (pInput[uiIndex] = 16#0D)
            AND (pInput[uiIndex + 1] = 16#0A) THEN
            bDone := TRUE;
            M_Decode := TRUE;
            RETURN;
        END_IF

        // 真实 HTTP/1.1 对端可能发送 trailer 字段;首版不消费字段语义,只验证终止空行并忽略其内容。
        uiScan := uiIndex;
        WHILE ((uiScan + 3) < uiInputLen)
            AND NOT ((pInput[uiScan] = 16#0D)
                AND (pInput[uiScan + 1] = 16#0A)
                AND (pInput[uiScan + 2] = 16#0D)
                AND (pInput[uiScan + 3] = 16#0A)) DO
            uiScan := uiScan + 1;
        END_WHILE

        IF ((uiScan + 3) < uiInputLen)
            AND (pInput[uiScan] = 16#0D)
            AND (pInput[uiScan + 1] = 16#0A)
            AND (pInput[uiScan + 2] = 16#0D)
            AND (pInput[uiScan + 3] = 16#0A) THEN
            bDone := TRUE;
            M_Decode := TRUE;
            RETURN;
这一段先回答对象在什么输入和状态下开始工作。阅读时要核对变量的初值、长度上限和启动条件,不能只看某个布尔量是否变成 TRUE。
片段二:状态推进、边界与输出
        END_IF
        bError := TRUE;
        eError := E_HttpError.iNeedMoreData;
        sDiagMsg := 'chunk trailer is incomplete';
        RETURN;
    END_IF

    IF (udiDecodedLength + udiChunkSize) > TO_UDINT(GVL_Http.cnMaxBodySize) THEN
        bError := TRUE;
        eError := E_HttpError.iBodyTooLarge;
        sDiagMsg := 'decoded body exceeds limit';
        RETURN;
    END_IF

    uiChunkSize := TO_UINT(udiChunkSize);
    IF ((TO_UDINT(uiIndex) + udiChunkSize + 1) > TO_UDINT(uiInputLen)) THEN
        bError := TRUE;
        eError := E_HttpError.iNeedMoreData;
        sDiagMsg := 'chunk data is incomplete';
        RETURN;
    END_IF

    IF NOT ((pInput[uiIndex + uiChunkSize] = 16#0D)
        AND (pInput[uiIndex + uiChunkSize + 1] = 16#0A)) THEN
        bError := TRUE;
        eError := E_HttpError.iChunkedDecodeFailed;
        sDiagMsg := 'chunk data CRLF is invalid';
        RETURN;
    END_IF

    // 只有通过长度和 CRLF 校验后才复制数据,保证输出不会保留半截非法 body。
    IF uiChunkSize > 0 THEN
        FOR uiCopyIndex := 0 TO uiChunkSize - 1 DO
            pWrite^ := pInput[uiIndex + uiCopyIndex];
            pWrite := pWrite + 1;
            udiDecodedLength := udiDecodedLength + 1;
        END_FOR
        pWrite^ := 0;
    END_IF

    uiIndex := uiIndex + uiChunkSize + 2;
END_WHILE

bError := TRUE;
eError := E_HttpError.iNeedMoreData;
sDiagMsg := 'terminal chunk is missing';
第二段继续展示同一连续源码范围。把它与第一段合起来,才能判断输入怎样被锁存、状态何时推进、边界何时满足,以及错误出口是否保留了足够诊断信息。
验证路径
| 场景 | 操作 | 通过口径 |
|---|---|---|
| 合法分块 | 多个块加 0 终止块 | 解码 Body 顺序正确 |
| 分号扩展 | 块长度后带扩展 | 长度计算不受扩展影响 |
| 坏十六进制 | chunk-size 含非法字符 | ChunkedDecodeFailed |
| 缺少 CRLF | 块数据边界错误 | 拒绝复制不完整 Body |
场景 1:合法分块
发送 4\r\nWiki\r\n5\r\npedia\r\n0\r\n\r\n 这一类标准分块输入。解码结果必须按块顺序拼成连续 Body,完成标志只能在 0 块和 trailer 结束以后出现。这里要同时核对写指针、累计长度和输出字符串,防止只在外部看起来返回了正确文本。
场景 2:分号扩展
把 chunk-size 写成 5;name=value,确认分号后的扩展不会进入长度换算。PLC 端只按前面的十六进制数取数据,扩展字段不应改变 Body,也不应被误认为非法字符。这个场景用于证明解析器没有把整行当成纯数字硬转。
场景 3:坏十六进制
发送 G\r\n... 或带非十六进制字符的块长度。期望错误应落在 chunk-size 解析阶段,而不是等到 Body 拷贝阶段才失败。错误发生后,输出 Body 必须保持原状态或清空,不能留下已经复制的半截数据。
场景 4:缺少 CRLF
构造块数据后缺少 CRLF 的输入。解码器必须先验证长度和边界,再复制数据;边界不完整时应返回需要更多数据或解码失败,而不是先把看见的字节写入输出。这个顺序决定了异常报文会不会污染下一次请求。
常见误判
- 用字符串结束符判断 Body,而不是按 Content-Length 或 chunk-size 计算字节边界。
- chunk-size 解析失败后仍复制已经收到的部分数据,留下半截业务 Body。
- 把 chunked 入站支持误写成当前实现也会生成 chunked 出站报文。
这些误判的共同点,是拿一个局部现象替代完整事务。定位时必须回到本篇的输入、状态、边界和输出四个坐标,并用相同输入完成回归。
这一篇你最该记住
- 消息边界必须由协议字段决定。
- chunked 的结束标志是 0 块,不是连接关闭。
- 校验通过之前不要修改最终 Body。
系列导航
- 系列:CodeSys HTTP 系列教程,第 09/28 篇。
- 阶段:服务器篇,职责线位置 5/7。
- 上一篇:第08篇
- 下一篇:第10篇
- 发布顺序:基础认知 -> Server -> Client -> 完整源码加更 -> 综合收束。
评论区预留
这里先保留评论和回复结构,不接入第三方服务。后续统一决定登录、匿名、审核、反垃圾和静态站兼容策略。